Видео с ютуба Compressed Llm

LLM Compression Explained: Build Faster, Efficient AI Models

TurboQuant: технология сжатия данных Google с шагом в 1 бит, которая уменьшает размер файлов LLM ...
Квантование LLM: просто о сложном
Я получил самую маленькую (и глупую) степень магистра права

Как LLM выживают в условиях низкой точности | Основы квантования
Compressing Large Language Models (LLMs) | w/ Python Code

Reinventing Entropy | Compression is Intelligence Part 1

1-Bit LLM: The Most Efficient LLM Possible?
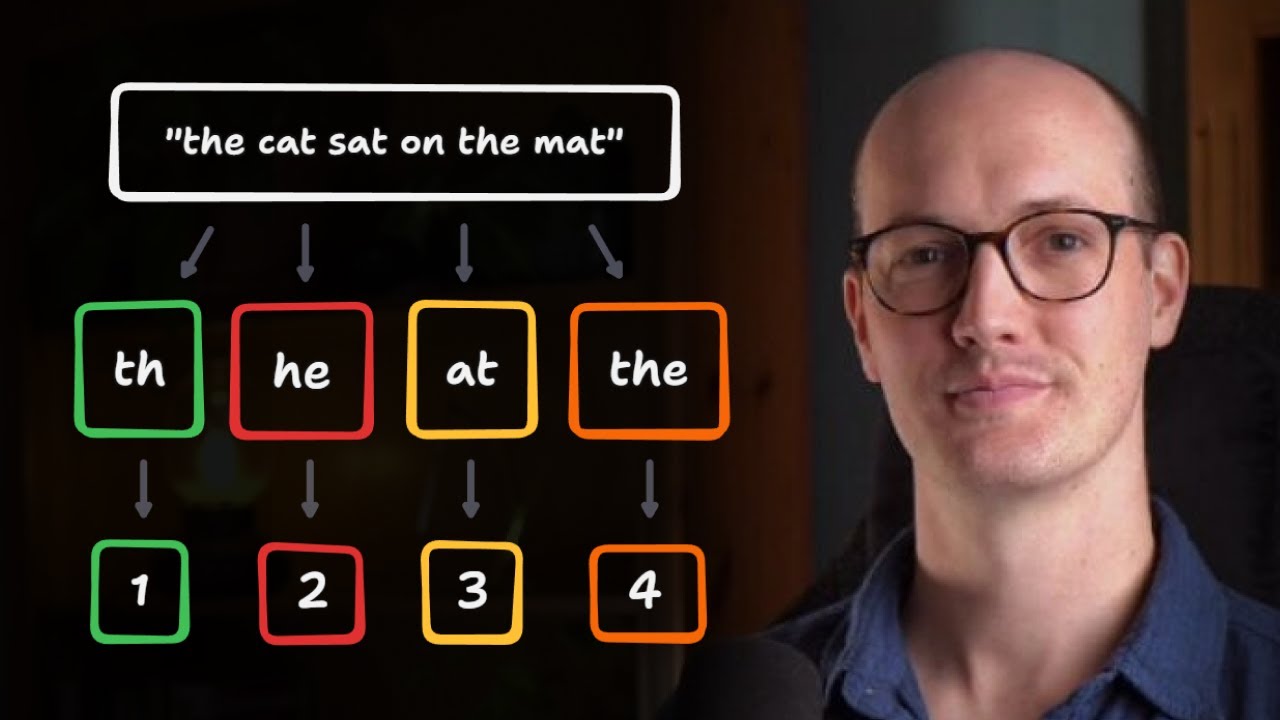
Большинство разработчиков не понимают, как работают токены LLM.

What is LLM quantization?

What is Prompt Caching? Optimize LLM Latency with AI Transformers

LLM Контекстное и оперативное сжатие: как добиться скорости без потерь.

I Compressed 6 Months of LLM Training Theory Into 19 Minutes
AI Compression is 300x Better (but we don't use it)
Your local LLM is 10x slower than it should be

Revolutionizing LLM Inference: LLMLingua's Breakthrough in Prompt Compression 🚀
Сократите расходы на LLM на 90%: лучший инструмент для сжатия AI-контекста (Headroom)
What is a Context Window? Unlocking LLM Secrets

LLM Compressor deep dive + walkthrough